问卷 JSON Schema 开源 & 问卷导入导出上线:让任何大模型都能生成可导入的问卷
news0012.html
今天,AI·智快问卷迎来两项更新:问卷定义 JSON Schema 正式开源,以 MIT 协议发布,任何大模型都能按这套规范生成可导入的问卷;小程序同步上线问卷导入 / 导出功能,并支持导出为换行分隔的可读文本。此外,本次还完成了架构改进,页面与资源加载速度明显加快。
一个解决“AI 生成的问卷能不能直接用”,一个解决“已有问卷能不能搬来搬去”,再加上“打开更快”。三件事合在一起,指向的是同一件事:让问卷在 AI、在你的系统、在我们的产品之间,真正流动起来。
问卷定义格式整理为独立的 JSON Schema,以 MIT 协议开源。任何大模型按它生成的 JSON,都能被程序稳定解析、被小程序直接导入。
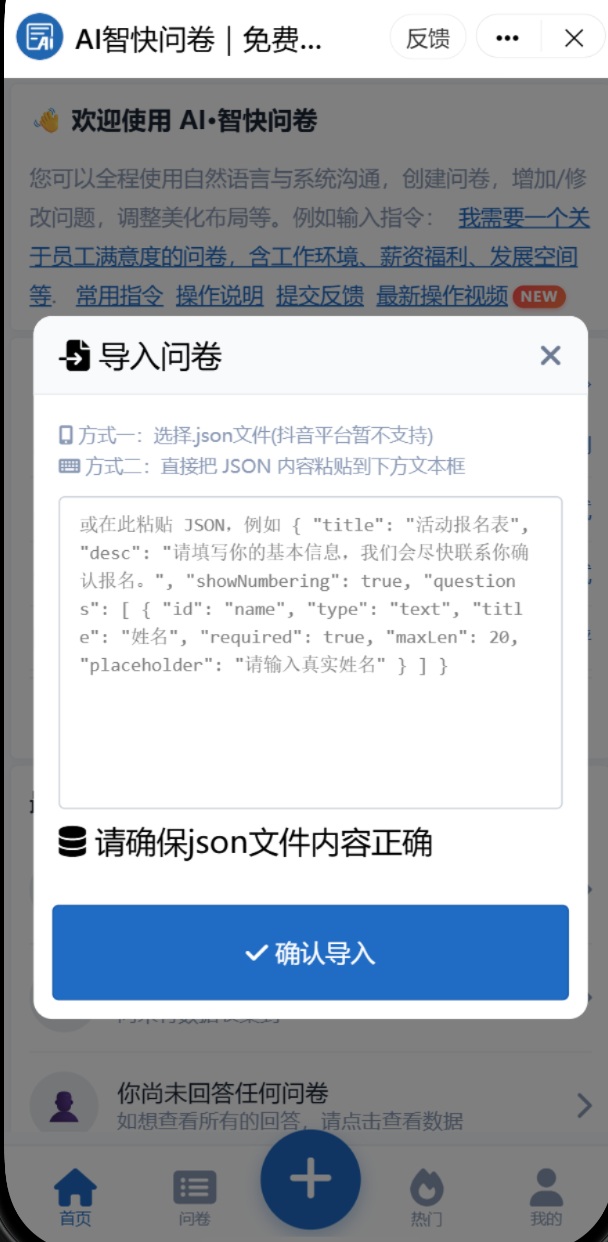
支持将问卷定义导出为 JSON,也可粘贴或选择 JSON 文件导入;同时支持导出为换行分隔的可读文本格式,便于导入腾讯问卷等其他问卷系统。
一、为什么要开源一套问卷 JSON 定义规范
让大模型生成问卷,最难的不是生成,是生成出来的东西能稳定地被程序解析。如果你试过让 GPT 或 Claude 直接生成一份问卷,大概率遇到过这些情况:字段名每次不一样、选择题忘了带选项、容器类型的 children 结构忽深忽浅、同一个字段这次叫 name 下次叫 userName。人看着能懂,程序一解析就报错。
我们不想每次都在 prompt 里写一大段格式说明,也不想在生成之后写一堆正则去修。更根本的问题是:如果没有一个明确的契约,AI 每次都在猜你想要什么格式,而猜的结果是不可复现的。所以我们定义了一套 JSON Schema,让 AI 生成的 JSON 必须符合这个契约,不符合就校验不通过。同时这套 schema 本身可以导入导出,不绑定我们自己的产品——任何系统都可以用它来描述一份收集表单。
一份最小的问卷定义长这样:
{
  "schemaVersion": "1.0",
  "title": "活动报名表",
  "questions": [
    { "id": "name", "type": "text", "title": "姓名", "required": true },
    { "id": "phone", "type": "phone", "title": "手机号", "required": true },
    { "id": "remark", "type": "textarea", "title": "备注" }
  ]
}
把这份 JSON Schema 喂给任何 AI,说一句“按这个格式生成一份收集购买需求的问卷,包含姓名、商品名、地址、备注”,它返回的 JSON 应该就是这样,并且可以直接导入,变成一份可填报的问卷。
三个设计目标
- AI 友好,而不是人类手写友好。这套 schema 的主要生成者是 LLM。字段命名直白、枚举封闭、约束尽量用 JSON Schema 原生表达——LLM 对
enum和required的理解远好于对一段自然语言描述的推断。 - 导入宽容,导出完整。导出时把所有能表达的信息都写进去;导入时遇到不认识的字段忽略并给警告,不整体报错。别的 AI 生成的 JSON 即使多了一些字段,也能导进来。
- 不绑定渲染。schema 只定义“问卷是什么”,不定义“长什么样”。颜色、布局、动画属于渲染层,导出时丢掉,导入时用默认样式,因此可以被任何前端或后端消费。
结构上,顶层只有 schemaVersion、title、desc、随机化与渐进式开关、评估规则等少数字段,其余都收在 questions 数组里。每个 question 支持 14 种类型:基础输入型(text / textarea / integer / decimal / phone / date / datetime)、选择型(radio / checkbox / yesno)、容器型(row / column / grid / matrix),容器可嵌套,matrix 的子项只允许选择题。容器和字段统一用 type 区分,AI 生成时只需理解一种节点形态,递归生成 children 即可。
让 AI 生成更稳的几个设计
能用 JSON Schema 原生约束的,绝不写在描述里。早期版本我们把“数字类型的 maxLen 不能超过 18”写在 description 里,结果 AI 生成的 JSON 里 maxLen 写 50 的情况比比皆是。后来改成 maximum: 18 这样的 if/then 约束,生成质量立刻稳定下来。
联动关系也显式写进 schema。比如“要求评估结果”在逻辑上要求“评估可执行”且“评估规则非空”,这个关系如果只写在文档里,AI 生成时大概率会漏;写成 if/then 之后,AI 会被约束“推着”把相关字段补全。还有一个看起来很小、实际影响很大的细节:默认值要和描述一致。schema 里的任何一个矛盾,AI 都会用它自己的方式“解决”,而解决方式不可控。
问卷的校验、跳转、联动,则放在独立的 script 字段里,写一段类 Epidata Chk 语法的纯文本脚本。之所以不用 JSON 描述逻辑,是因为逻辑用代码表达比用 JSON 嵌套更自然,而脚本本身也是由 AI 生成的。目前开放了 ASSERT / DISABLES / HIDEROWS / HIDES / JUMPS / RANGE / REPEAT 等有限命令和函数,选型原则是“AI 能稳定生成”,不是“图灵完备”——未列出的命令不是不支持,只是怕 AI 理解不正确,暂时不让 AI 生成。
二、问卷导入 / 导出:JSON 与换行文本双向流动
Schema 开源之后,最直接的变化是:AI 生成的问卷 JSON 可以一键导入小程序,变成一份完整、可编辑、可分享的问卷。导入之后,它和在小程序里原生创建的问卷没有任何区别:可以继续编辑字段、调整选项、配置处理状态、发布分享,所有能力都在。这不是一个“只读预览”或“一次性渲染”,而是完整的问卷对象。
除了 JSON,我们还补上了换行分隔的可读文本导出。有些问卷系统不认 JSON,但认“一行一题”的纯文本格式。导出成这种格式后,可以直接粘贴到腾讯问卷等支持文本导入的系统里,已有问卷不必从零重抄一遍。
| 能力 | 说明 | 典型用途 |
|---|---|---|
| 导出 JSON | 完整导出问卷定义,字段、题型、选项、逻辑脚本一并带走 | 备份、迁移、交给其他系统或 AI 继续处理 |
| 导入 JSON | 支持粘贴 JSON 文本,或选择本地 JSON 文件导入 | 把 AI 生成的问卷变成可填报问卷;复制已有问卷结构 |
| 导出换行文本 | 导出为一行一题的可读文本格式 | 导入腾讯问卷等其他支持文本导入的问卷系统 |
三、架构改进:打开更快了
本次同步完成了架构层面的改进,页面与静态资源的加载路径做了优化,三端的打开速度与切换流畅度都有明显提升。这一项没有新按钮,但你在使用时的第一感受会变——尤其是从首页进入问卷列表、从对话切到预览这些高频动作,等待感更短了。
四、操作指引
更新到最新版小程序即可使用,无需额外配置。
用 AI 生成并导入一份问卷
- 打开 https://github.com/qodespeng/ai-survey-schema,取到 schema/survey.schema.json。
- 把 schema 丢给任意 AI,附一句“按这个 JSON Schema 生成一份 XX 问卷的 JSON”。
- 打开 AI·智快问卷小程序,在问卷列表页点击“导入”。
- 粘贴 AI 返回的 JSON,或选择本地 JSON 文件,确认导入。
- 导入后的问卷可直接编辑、分享、收集数据,与原生创建的问卷完全一致。
导出问卷定义
- 在问卷列表页找到目标问卷,点击“管理”。
- 选择“复制 JSON 到剪贴板”或“复制 Text 到剪贴板”。
- JSON 可保存备份或交给其他系统;Text 可粘贴到腾讯问卷等支持文本导入的问卷系统。
写在最后
这套 schema 是我们内部产品在用的格式,整理开源出来有两个目的。第一,共享:让“AI 生成问卷”这件事有一个可复用的契约,不用每个团队都从头设计一遍 prompt 和格式校验。第二,落地:如果你刚好需要一份问卷——社群报名、活动收集、购买需求登记——可以用任意 AI 按这套 schema 生成,然后导入 AI·智快问卷小程序,直接变成一份可分享、可收集、可继续编辑的问卷。
我们不回避这一点:开源这套 schema,既希望它作为一个开放规范被更多人使用和改进,也希望当你真的需要发一份问卷时,能想到用这套格式生成、然后导入我们的产品。规范是开放的,产品是其中一个顺手的落点,两者不矛盾。
仓库地址:https://github.com/qodespeng/ai-survey-schema(MIT 协议,欢迎 issue 与 PR)。现在打开微信 / 抖音 / 支付宝搜索“AI·智快问卷”,试试导入一份 AI 生成的问卷吧。
AI·智快问卷:微信小程序、抖音小程序、支付宝小程序同步上线。AI 驱动问卷生成、评估与统计,支持问卷 JSON 导入导出,完全免费使用。